Sztuczna inteligencja działa przez przetwarzanie danych wejściowych i wykorzystanie algorytmu lub wytrenowanego modelu do wygenerowania wyniku. Może nim być odpowiedź tekstowa, przewidywanie, rekomendacja, klasyfikacja albo decyzja.
Nie wszystkie systemy AI działają w ten sam sposób. Część wykorzystuje ręcznie ustalone reguły, a część uczy się zależności na podstawie przykładów. Aby ocenić wynik takiego systemu, sprawdź, jakie dane otrzymał, do jakiego zadania został przygotowany i jakie konsekwencje może mieć ewentualny błąd.
Najważniejsze wnioski
- AI nie jest jednym programem ani jedną metodą. To szeroka dziedzina obejmująca różne systemy przetwarzające dane i generujące określone wyniki.
- Wiele współczesnych modeli wykrywa zależności na podstawie przykładów, zamiast otrzymywać osobną regułę dla każdej możliwej sytuacji.
- Jakość wyniku zależy od liczby danych, ale także od ich poprawności, reprezentatywności i dopasowania do zadania.
- Sieci neuronowe i głębokie uczenie są metodami wykorzystywanymi w AI, lecz nie są synonimem całej sztucznej inteligencji.
- Płynna i przekonująca odpowiedź systemu może być błędna. Im większe znaczenie wyniku, tym dokładniejszej wymaga on weryfikacji.
Czym jest AI i jakie są rodzaje AI?
Sztuczna inteligencja, czyli AI, to dziedzina informatyki zajmująca się tworzeniem systemów wykonujących zadania wymagające analizy, rozpoznawania wzorców, przewidywania lub podejmowania decyzji. Według definicji OECD system AI otrzymuje dane wejściowe i na ich podstawie generuje wynik, taki jak treść, rekomendacja, przewidywanie albo decyzja.
AI obejmuje wiele metod. Uczenie maszynowe jest jedną z nich, ale nie wyczerpuje całej dziedziny. Do AI można zaliczyć również systemy eksperckie lub rozwiązania oparte na regułach i algorytmach heurystycznych.
Wąska AI wykonuje określone zadania, na przykład rozpoznaje mowę, klasyfikuje obrazy albo rekomenduje treści. Ogólna sztuczna inteligencja, określana jako AGI, pozostaje koncepcją systemu zdolnego do wykonywania szerokiego zakresu zadań intelektualnych na poziomie porównywalnym z człowiekiem. Generatywna AI jest natomiast kategorią systemów tworzących teksty, obrazy, dźwięki lub inne treści. Nie jest synonimem całej AI.
Sztuczna nadinteligencja oznacza hipotetyczny system przewyższający człowieka w większości obszarów poznawczych. Nie należy traktować jej jako powszechnie dostępnej technologii.
Nie takie to straszne jak się nam wydaje – jak działa AI?
System AI otrzymuje dane, przetwarza je według ustalonego algorytmu lub parametrów modelu, rozpoznaje istotne zależności i generuje wynik. Dane wejściowe mogą mieć postać tekstu, obrazu, dźwięku, liczb, historii zachowań albo sygnałów z czujników.
Uproszczony proces działania AI można przedstawić w pięciu krokach:
- System otrzymuje lub zbiera dane wejściowe.
- Dane są przygotowywane do przetwarzania, na przykład porządkowane albo zamieniane na wartości liczbowe.
- Algorytm lub model przetwarza informacje zgodnie z zapisanymi regułami albo wyuczonymi parametrami.
- System oblicza prawdopodobny wynik na podstawie wykrytych wzorców i zależności.
- Generuje odpowiedź, przewidywanie, rekomendację, klasyfikację lub decyzję.
W modelach uczenia maszynowego parametry są wcześniej dopasowywane podczas treningu. Korzystanie z gotowego modelu dla nowych danych nazywa się inferencją. Trening i inferencja są odrębnymi etapami, dlatego model nie musi uczyć się od początku podczas każdego zapytania.
Tradycyjne programowanie i uczenie maszynowe mogą służyć do różnych zadań. Żadne z tych podejść nie jest automatycznie lepsze.
| Kryterium | Tradycyjny program regułowy | Model uczony na danych |
|---|---|---|
| Podstawa działania | Reguły zapisane przez programistę | Parametry dopasowane na przykładach |
| Reakcja na nowe dane | Stosuje zdefiniowane warunki | Wykorzystuje poznane zależności |
| Typowe zastosowanie | Jasny i stabilny zestaw reguł | Złożone wzorce trudne do ręcznego opisania |
| Główne ryzyko | Brak reguły dla nietypowej sytuacji | Błąd wynikający z danych lub niedopasowania modelu |
Program regułowy sprawdza się wtedy, gdy warunki można dokładnie opisać, a model uczony na danych jest przydatny przy złożonych i zmiennych wzorcach. W praktyce oba podejścia często są łączone w jednym systemie.
Rola danych i uczenie maszynowe
Uczenie maszynowe polega na dopasowywaniu parametrów modelu na podstawie danych, tak aby poprawić wyniki dla określonego zadania. Model otrzymuje przykłady treningowe, popełnia błędy, a następnie koryguje parametry zgodnie z zastosowaną metodą uczenia.
W uczeniu nadzorowanym dane zawierają oczekiwane odpowiedzi. Przykładem mogą być wiadomości oznaczone wcześniej jako spam lub niespam. Uczenie nienadzorowane służy do wykrywania struktur bez przypisanej poprawnej odpowiedzi dla każdego przykładu, na przykład do grupowania podobnych zachowań użytkowników.
Uczenie ze wzmocnieniem wykorzystuje sygnał nagrody lub kary. System testuje działania i stopniowo doskonali strategię, która prowadzi do lepszego wyniku. Nagroda jest w tym przypadku wartością matematyczną, a nie emocją odczuwaną przez system.
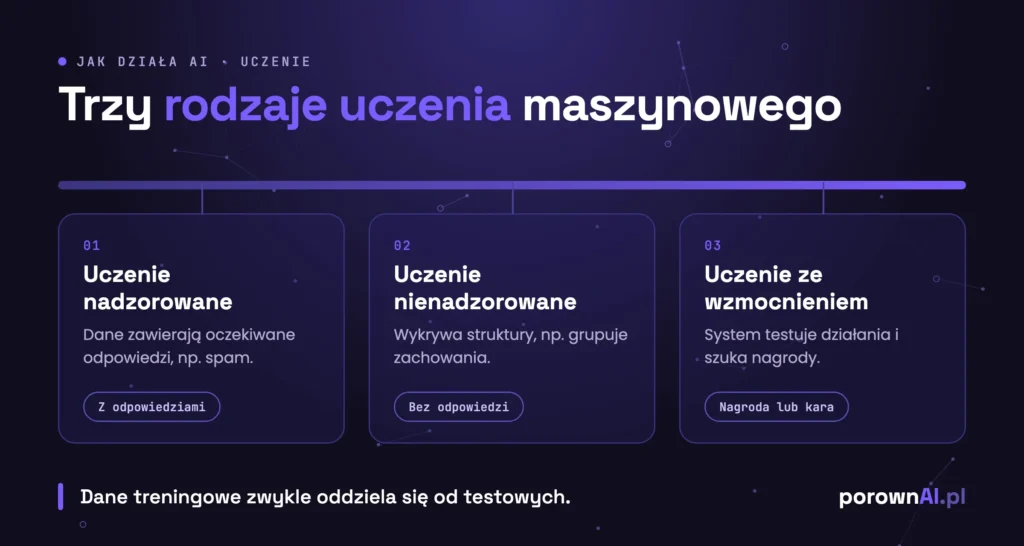
Dane treningowe zwykle oddziela się od danych służących do testowania modelu. Duża liczba przykładów nie gwarantuje wysokiej dokładności, gdy dane są błędne, niereprezentatywne lub niedopasowane do zadania. Znaczenie ma więc ich ilość, jakość, sposób przygotowania i zakres sytuacji, które reprezentują.
Sieci neuronowe i głębokie uczenie
Sieć neuronowa to model obliczeniowy złożony z połączonych elementów rozmieszczonych w warstwach. Warstwa wejściowa odbiera dane, warstwy pośrednie kolejno je przekształcają, a warstwa wyjściowa generuje rezultat.
Głębokie uczenie, czyli deep learning, wykorzystuje sieci zawierające wiele warstw przetwarzania. Ułatwia to analizowanie złożonych wzorców w tekstach, obrazach i nagraniach dźwiękowych. Nazwa sieci neuronowej wynika z inspiracji układem nerwowym, ale model nie działa identycznie jak ludzki mózg i nie stanowi dowodu świadomości.
Różne, ciekawe, mądre zastosowania AI: język, obraz i AI w telefonie
Ten sam ogólny schemat działania może służyć do wielu zadań, ponieważ zmieniają się rodzaj danych wejściowych, cel modelu i oczekiwany wynik. System językowy przetwarza tekst, model obrazu analizuje dane wizualne, a system rekomendacyjny wykorzystuje informacje o zachowaniach lub preferencjach.
Przykłady pokazują, co system otrzymuje i jaki rezultat może wygenerować:
- Chatbot: tekst użytkownika → analiza języka → wygenerowana odpowiedź.
- Aparat w telefonie: obraz → rozpoznanie sceny lub twarzy → dopasowanie ustawień.
- Wirtualny asystent: dźwięk → rozpoznanie mowy → interpretacja polecenia.
- Platforma streamingowa: historia aktywności → analiza preferencji → rekomendacje.
- System finansowy: dane o transakcji → wykrywanie anomalii → oznaczenie ryzyka.
Modele językowe uczą się zależności występujących w sekwencjach tekstu i na tej podstawie generują kolejne elementy odpowiedzi. Spójne zdanie nie dowodzi jednak, że model rozumie jego znaczenie dokładnie tak jak człowiek.
AI w telefonie może wspierać rozpoznawanie mowy, filtrowanie treści, poprawianie zdjęć, wyszukiwanie obiektów i personalizację funkcji. Część operacji odbywa się bezpośrednio na urządzeniu, a część może wymagać połączenia z systemem zewnętrznym. Użytkownik często korzysta z AI, nawet gdy funkcja nie jest wprost oznaczona tą nazwą.
Historia AI: od testu Turinga do generatywnej AI
Historia AI zaczęła się na długo przed pojawieniem się współczesnych chatbotów. W 1950 roku Alan Turing opisał sposób oceny, czy zachowanie maszyny podczas rozmowy może być trudne do odróżnienia od zachowania człowieka. Test Turinga dotyczy zachowania w rozmowie, a nie potwierdzenia świadomości lub ludzkiego sposobu rozumienia.
W 1956 roku podczas projektu badawczego w Dartmouth przyjęto określenie „artificial intelligence” i ukształtowano AI jako odrębną dziedzinę badań. Później rozwijano między innymi systemy eksperckie, uczenie maszynowe i sieci neuronowe.
Rozwój przyspieszyły większe zbiory danych, wydajniejsze zasoby obliczeniowe oraz postęp w metodach trenowania modeli. Generatywna AI jest kolejnym etapem tej historii, a nie początkiem całej sztucznej inteligencji.
Robot też nie musi być doskonały. Ograniczenia AI: dlaczego system może się mylić?
System AI może wygenerować błędny wynik, ponieważ opiera się na danych, parametrach i celu określonym podczas projektowania oraz treningu. Nie ma automatycznego dostępu do każdej prawdziwej, kompletnej i aktualnej informacji.
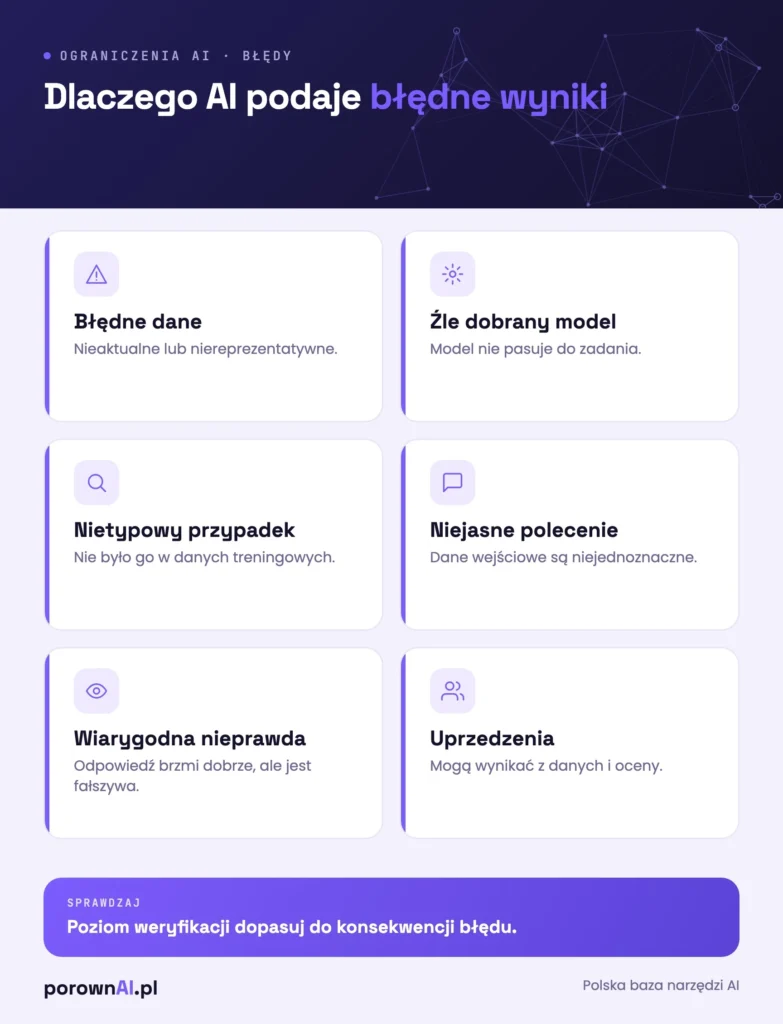
Błąd może wynikać z kilku przyczyn jednocześnie:
- błędnych, nieaktualnych lub niereprezentatywnych danych,
- niedopasowania modelu do konkretnego zadania,
- nietypowego przypadku, który nie występował w danych treningowych,
- niejednoznacznych danych wejściowych lub polecenia,
- wygenerowania wiarygodnie brzmiącej, lecz nieprawdziwej odpowiedzi.
Modele mogą również odtwarzać lub wzmacniać uprzedzenia obecne w danych, sposobie oceny i procesie projektowania. Nie każdy problem wynika więc wyłącznie ze słabego zbioru treningowego.
Korzystanie z systemów przetwarzających duże zbiory informacji może wiązać się z ryzykiem prywatności. Nie wpisuj danych poufnych bez sprawdzenia zasad działania konkretnej usługi, sposobu przetwarzania informacji i warunków ich przechowywania.
Poziom weryfikacji dopasuj do konsekwencji błędu. Pomoc przy zmianie stylu zdania wiąże się z innym ryzykiem niż porada dotycząca zdrowia, prawa, finansów lub bezpieczeństwa. W ważnych sprawach sprawdź wynik w niezależnym i właściwym źródle.
Przyszłość AI: czego możemy się spodziewać? (Czy za 10 lat spęłni się scenariusz z Terminatora?)
Systemy AI mogą obsługiwać coraz bardziej złożone zadania i łączyć tekst, obraz, dźwięk oraz inne rodzaje danych. Rozwój może prowadzić do szerszej automatyzacji etapów pracy i włączania modeli do istniejących narzędzi, urządzeń oraz procesów.
Automatyzacja będzie dotyczyć przede wszystkim konkretnych czynności, takich jak analiza dokumentów, klasyfikacja informacji, tworzenie wersji roboczych lub wykrywanie anomalii. Nie oznacza to automatycznie zastąpienia całych zawodów.
Większa autonomia systemu zwiększa znaczenie monitorowania jego wyników, kontroli danych i jasnego przypisania odpowiedzialności. AGI pozostaje koncepcją badawczą, dlatego nie da się wiarygodnie podać terminu jej powstania ani traktować jej jako standardowej funkcji współczesnych narzędzi.
Dla użytkownika najważniejsza pozostaje umiejętność rozpoznania, jakie dane otrzymuje system, jaki wynik generuje i jak poważne mogą być skutki błędu.
Najczęstsze pytania
Na czym polega działanie sztucznej inteligencji?
System AI otrzymuje dane wejściowe, przetwarza je za pomocą algorytmu lub modelu i generuje określony wynik. Może nim być przewidywanie, rekomendacja, treść, klasyfikacja albo decyzja. Dokładny mechanizm zależy od rodzaju systemu i zadania.
Skąd sztuczna inteligencja bierze dane?
Dane mogą pochodzić ze zbiorów treningowych, baz organizacji, urządzeń, czujników albo informacji przekazanych przez użytkownika. Źródło zależy od konkretnego systemu i jego zastosowania. Nie każdy model ma dostęp do internetu lub aktualnych informacji.
Czy AI uczy się podczas każdej rozmowy?
Nie należy zakładać, że każda rozmowa automatycznie trenuje model. Gotowy system zazwyczaj korzysta z parametrów dopasowanych podczas wcześniejszego treningu. Ewentualna aktualizacja jest osobnym procesem zależnym od konstrukcji modelu i zasad usługi.
Czy sztuczna inteligencja myśli jak człowiek?
Nie ma podstaw, aby zakładać, że współczesne systemy AI myślą lub rozumieją świat dokładnie tak jak człowiek. Mogą sprawnie rozpoznawać i generować wzorce bez ludzkiego doświadczenia, świadomości i sposobu interpretowania znaczeń.
Dlaczego AI podaje błędne odpowiedzi?
Błąd może wynikać z danych, niedopasowania modelu, niejednoznacznego polecenia albo sposobu generowania wyniku. Płynna i przekonująca forma nie gwarantuje prawdziwości odpowiedzi. Ważne informacje zweryfikuj w niezależnym źródle.
Jak działa sztuczna inteligencja w telefonie?
Telefon może używać modeli AI do rozpoznawania mowy, twarzy i obiektów, poprawiania zdjęć, filtrowania treści oraz personalizacji funkcji. Część obliczeń może odbywać się na urządzeniu, a część w systemie zewnętrznym. Zależy to od aplikacji i sposobu zaprojektowania usługi.